
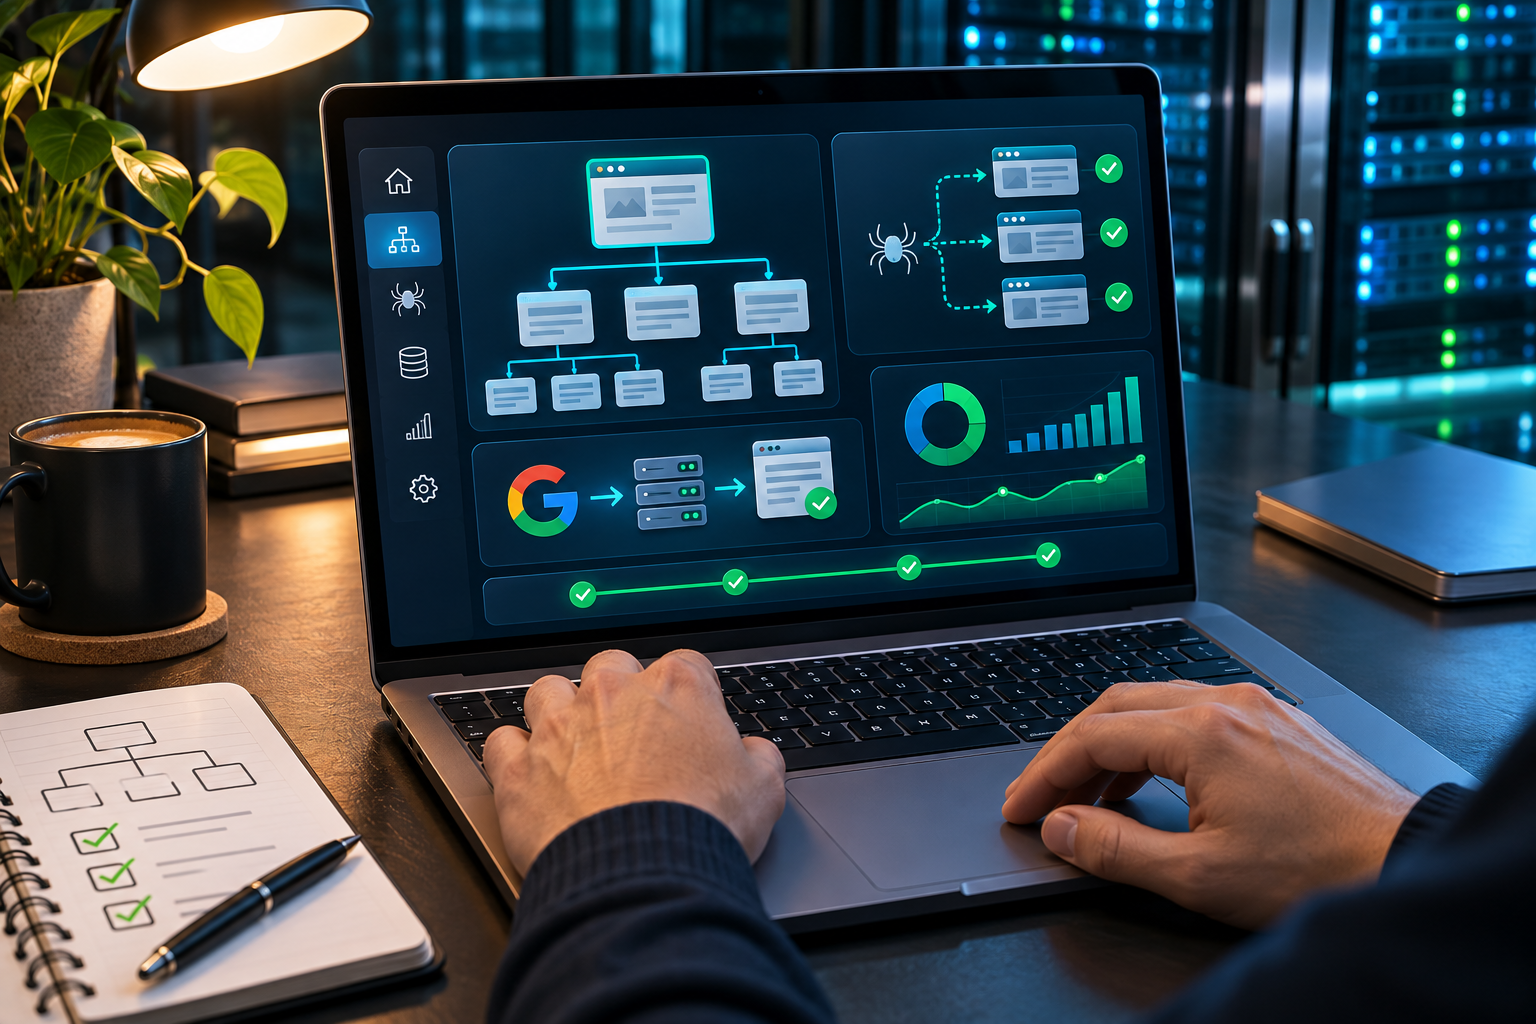
Strona może wyglądać poprawnie, szybko otwierać się na komputerze właściciela i nadal tracić widoczność przez problemy, których nie widać na pierwszy rzut oka. Błędny canonical, przypadkowy noindex, łańcuch przekierowań albo treść generowana dopiero po wykonaniu skryptu potrafią sprawić, że wartościowy adres nie zostanie poprawnie zrozumiany przez wyszukiwarkę. Audyt techniczny SEO służy właśnie do oddzielenia takich usterek od zwykłych wahań pozycji.
Największym błędem jest zaczynanie od listy przypadkowych komunikatów z jednego narzędzia. Audyt powinien połączyć cztery perspektywy: możliwość odkrycia adresu, możliwość pobrania dokumentu, decyzję o indeksowaniu oraz jakość strony po zaindeksowaniu. Dopiero zestawienie logów, map witryny, nagłówków HTTP, kodu HTML i danych o ruchu pozwala stwierdzić, czy problem dotyczy całej domeny, pojedynczego szablonu czy tylko kilku URL-i.
Poniższa procedura jest przeznaczona dla właścicieli serwisów, sklepów i zespołów marketingowych, które chcą zamienić techniczne obserwacje w wykonalny plan. Jeśli potrzebujesz wdrożenia zaleceń, zobacz usługę optymalizacji i przebudowy strony pod SEO.
Co naprawdę sprawdza audyt techniczny SEO
Audyt nie jest oceną estetyki ani raportem z liczbą błędów. Jego zadaniem jest pokazanie, czy robot może dotrzeć do ważnych stron, otrzymać prawidłową odpowiedź, odczytać główną treść i przypisać ją do właściwego adresu kanonicznego. Każdy wniosek powinien zawierać dowód: przykładowe URL-e, skalę zjawiska, wpływ na biznes oraz warunek uznania poprawki za zakończoną.
Przydatny podział obejmuje poziom domeny, szablonu i konkretnego dokumentu. Usterka certyfikatu lub robots.txt może dotyczyć całego serwisu. Wadliwa paginacja zwykle obejmuje jeden typ archiwum. Brak treści albo zły canonical może dotyczyć pojedynczej podstrony. Taki podział ogranicza ryzyko, że kosztowna zmiana globalna zostanie wdrożona z powodu jednostkowego przypadku.
Indeksowanie zaczyna się od listy ważnych adresów
Przed uruchomieniem crawlera warto zbudować listę adresów, które rzeczywiście powinny generować ruch: ofert, kategorii, produktów, poradników i lokalizacji. Następnie porównuje się ją z adresami obecnymi w mapie XML, linkowaniu wewnętrznym i wynikach wyszukiwania. Różnice są często ważniejsze niż sam wykaz błędów. Strona biznesowo istotna, której nie ma w żadnej ścieżce odkrywania, ma małą szansę na stabilną widoczność.
Dla każdego adresu ustala się oczekiwany stan: indeksowany, dostępny dla robota, zwracający 200, kanoniczny do siebie i osiągalny w kilku kliknięciach. Parametry filtrów, wyniki wewnętrznej wyszukiwarki oraz techniczne duplikaty zwykle otrzymują inny status. Ta prosta macierz staje się punktem odniesienia podczas testów po wdrożeniu.
Robots.txt, meta robots i nagłówki X-Robots-Tag
Plik robots.txt steruje pobieraniem, ale sam w sobie nie jest niezawodnym mechanizmem usuwania adresu z indeksu. Meta robots i nagłówek X-Robots-Tag przekazują decyzję o indeksowaniu dopiero wtedy, gdy robot może pobrać zasób. Blokada pobierania połączona z oczekiwaniem na odczyt noindex jest więc sprzeczna. Audyt powinien sprawdzić te warstwy łącznie, a nie w osobnych tabelach.
Szczególnej uwagi wymagają środowiska testowe, pliki PDF, obrazy, wyniki filtrowania i parametry używane przez kampanie. Reguły powinny być możliwie wąskie. Jeden nieprzemyślany wzorzec z gwiazdką potrafi objąć prawidłowe podkatalogi, dlatego każdą zmianę warto testować na zestawie adresów pozytywnych i negatywnych.
Canonical i duplikaty bez mechanicznego kasowania stron
Znacznik canonical jest wskazówką, a nie poleceniem. Jeżeli wskazany adres różni się treścią, jest zablokowany, przekierowuje albo nie występuje w linkowaniu, wyszukiwarka może wybrać inny wariant. W audycie porównuje się canonical deklarowany, canonical wybrany przez Google, adresy z mapy XML oraz cele linków wewnętrznych. Wszystkie te sygnały powinny opowiadać tę samą historię.
Duplikaty należy rozwiązywać zgodnie z funkcją strony. Identyczne wersje protokołu i hosta zwykle wymagają przekierowania. Warianty sortowania mogą pozostać dostępne użytkownikowi, ale nie muszą trafiać do indeksu. Osobne podstrony lokalne powinny mieć własną wartość informacyjną, a nie tylko zamienioną nazwę miejscowości. Pozycjonowanie stron zaczyna działać stabilniej, gdy architektura nie wysyła sprzecznych sygnałów.
Kody odpowiedzi i przekierowania
Każdy ważny dokument powinien zwracać kod 200 bez przechodzenia przez serię przekierowań. Adres przeniesiony na stałe powinien prowadzić jednym 301 do najbliższego odpowiednika. Przekierowanie wszystkich usuniętych podstron na stronę główną utrudnia użytkownikowi kontynuację zadania i może zostać potraktowane jak miękki błąd 404.
Audyt obejmuje również odpowiedzi 5xx, sporadyczne timeouty oraz różnice między robotem a zwykłą przeglądarką. Warto wykonać kilka prób w różnych porach, ponieważ problem z limitem zasobów może nie ujawnić się podczas pojedynczego skanu. Przy migracji konieczna jest osobna mapa stary–nowy URL i kontrola linków wewnętrznych po przełączeniu domeny.
Renderowanie JavaScript i treść widoczna dla robota
Nowoczesny interfejs może załadować nagłówek, opis produktu albo linki dopiero po wykonaniu JavaScript. Nie oznacza to automatycznie problemu, ale zwiększa zależność od zasobów, czasu i poprawnego renderowania. Porównanie surowego HTML z DOM po wykonaniu skryptów pokazuje, czy główna treść oraz linki są dostępne od razu.
Najważniejsze informacje powinny być odporne na awarię pojedynczego skryptu. Dotyczy to tytułu, ceny, opisu, nawigacji i linków do kolejnych poziomów serwisu. Rozwiązaniem może być renderowanie po stronie serwera, generowanie statyczne albo uproszczenie komponentu. Decyzję podejmuje się na podstawie skali, a nie samego faktu użycia JavaScript.
Mapa XML i linkowanie wewnętrzne jako dwa różne sygnały
Mapa XML powinna zawierać wyłącznie kanoniczne, indeksowalne adresy zwracające 200. Nie zastępuje jednak linkowania. Jeżeli podstrona istnieje tylko w sitemapie, robot może ją odkryć, ale otrzymuje słaby sygnał znaczenia i kontekstu. Dlatego ważne treści powinny być osiągalne z kategorii, menu kontekstowego lub powiązanych poradników.
W audycie mierzy się głębokość kliknięć, liczbę linków przychodzących oraz teksty kotwic. Strony osierocone porównuje się z danymi analitycznymi i bazą CMS. Czasem należy je włączyć do architektury, czasem połączyć z mocniejszym materiałem, a czasem świadomie usunąć. Automatyczne dodawanie setek linków w stopce rzadko rozwiązuje problem jakościowo.
Wydajność, Core Web Vitals i stabilność serwera
Szybkość jest częścią doświadczenia użytkownika i może pośrednio wpływać na skuteczność całego kanału. Warto rozdzielić dane terenowe od laboratoryjnych. Core Web Vitals pokazują realne doświadczenia odpowiedniej grupy użytkowników, a test laboratoryjny pomaga znaleźć przyczynę: zbyt duży obraz LCP, blokujący CSS, długie zadanie JavaScript albo przesunięcie układu.
Priorytet otrzymują szablony z ruchem i konwersjami. Optymalizacja jednego lekkiego wpisu nie naprawi ciężkiej karty produktu. Kontrola powinna objąć również TTFB, cache, kompresję, fonty, obrazy oraz zachowanie przy większym obciążeniu. Po wdrożeniu powtarza się pomiar na tym samym zestawie URL-i.
Jak ustalić kolejność napraw
Rekomendacje można ocenić według czterech kryteriów: wpływu na indeksowanie, liczby dotkniętych stron, wartości biznesowej oraz kosztu wdrożenia. Krytyczny noindex na usługach wyprzedza dopracowanie danych strukturalnych w archiwum bez ruchu. Szybka naprawa błędnych linków może wyprzedzić długą przebudowę, jeśli daje natychmiastowy efekt i nie koliduje z planem docelowym.
Dobra lista wdrożeniowa zawiera właściciela zadania, przykłady przed zmianą, oczekiwany rezultat, sposób testu i plan wycofania. Po publikacji trzeba ponownie przeskanować serwis, sprawdzić nagłówki oraz obserwować logi i indeksowanie. Audyt kończy się dopiero wtedy, gdy poprawka została zweryfikowana, a nie w chwili wysłania dokumentu.
Lista kontrolna przed zamknięciem audytu
- ważne adresy są znane i przypisano im oczekiwany stan,
- robots.txt, meta robots i X-Robots-Tag nie przeczą sobie,
- canonical, sitemap i linki wskazują te same warianty,
- nie ma łańcuchów przekierowań ani błędów na stronach biznesowych,
- główna treść jest dostępna w renderowanym dokumencie,
- strony osierocone otrzymały świadomą decyzję,
- zalecenia mają priorytet, właściciela i test odbioru.
Jeśli audyt ma prowadzić do wzrostu, należy połączyć technikę z treścią i popytem. Naprawiona podstrona bez jasnej odpowiedzi na intencję nadal może nie zdobyć widoczności. Z kolei świetny materiał blokowany przez błędną dyrektywę nie wykorzysta potencjału. Dopiero spójność obu warstw daje przewidywalny fundament.
Najczęściej zadawane pytania
Ile trwa audyt techniczny SEO?
Czas zależy od liczby szablonów, adresów i integracji. Mały serwis można zbadać w kilka dni, natomiast sklep z filtrami, wieloma wersjami językowymi i historią migracji wymaga dłuższej analizy oraz próby na danych z kilku źródeł.
Czy audyt gwarantuje wzrost pozycji?
Nie. Audyt wykrywa bariery i porządkuje naprawy, lecz wynik zależy również od popytu, jakości treści, konkurencji i autorytetu domeny. Można natomiast sprawdzić, czy zalecenia zostały wdrożone i czy poprawiły stan techniczny.
Czy robots.txt usuwa stronę z Google?
Nie jest to pewny sposób usunięcia adresu z indeksu. Blokada może uniemożliwić odczyt dyrektywy noindex. Sposób działania trzeba dobrać do sytuacji i sprawdzić na konkretnych URL-ach.
Jak często powtarzać audyt?
Pełny audyt warto wykonać po większej migracji, zmianie CMS lub architektury. Krótsze kontrole dobrze prowadzić cyklicznie oraz po wdrożeniach wpływających na szablony, linkowanie lub indeksowanie.
Co jest potrzebne do rozpoczęcia?
Lista ważnych obszarów serwisu, dostęp do CMS i analityki, mapy XML, informacje o ostatnich zmianach oraz możliwość rozmowy z osobą techniczną. Logi serwera i dane z narzędzi wyszukiwarki znacznie zwiększają trafność diagnozy.
