
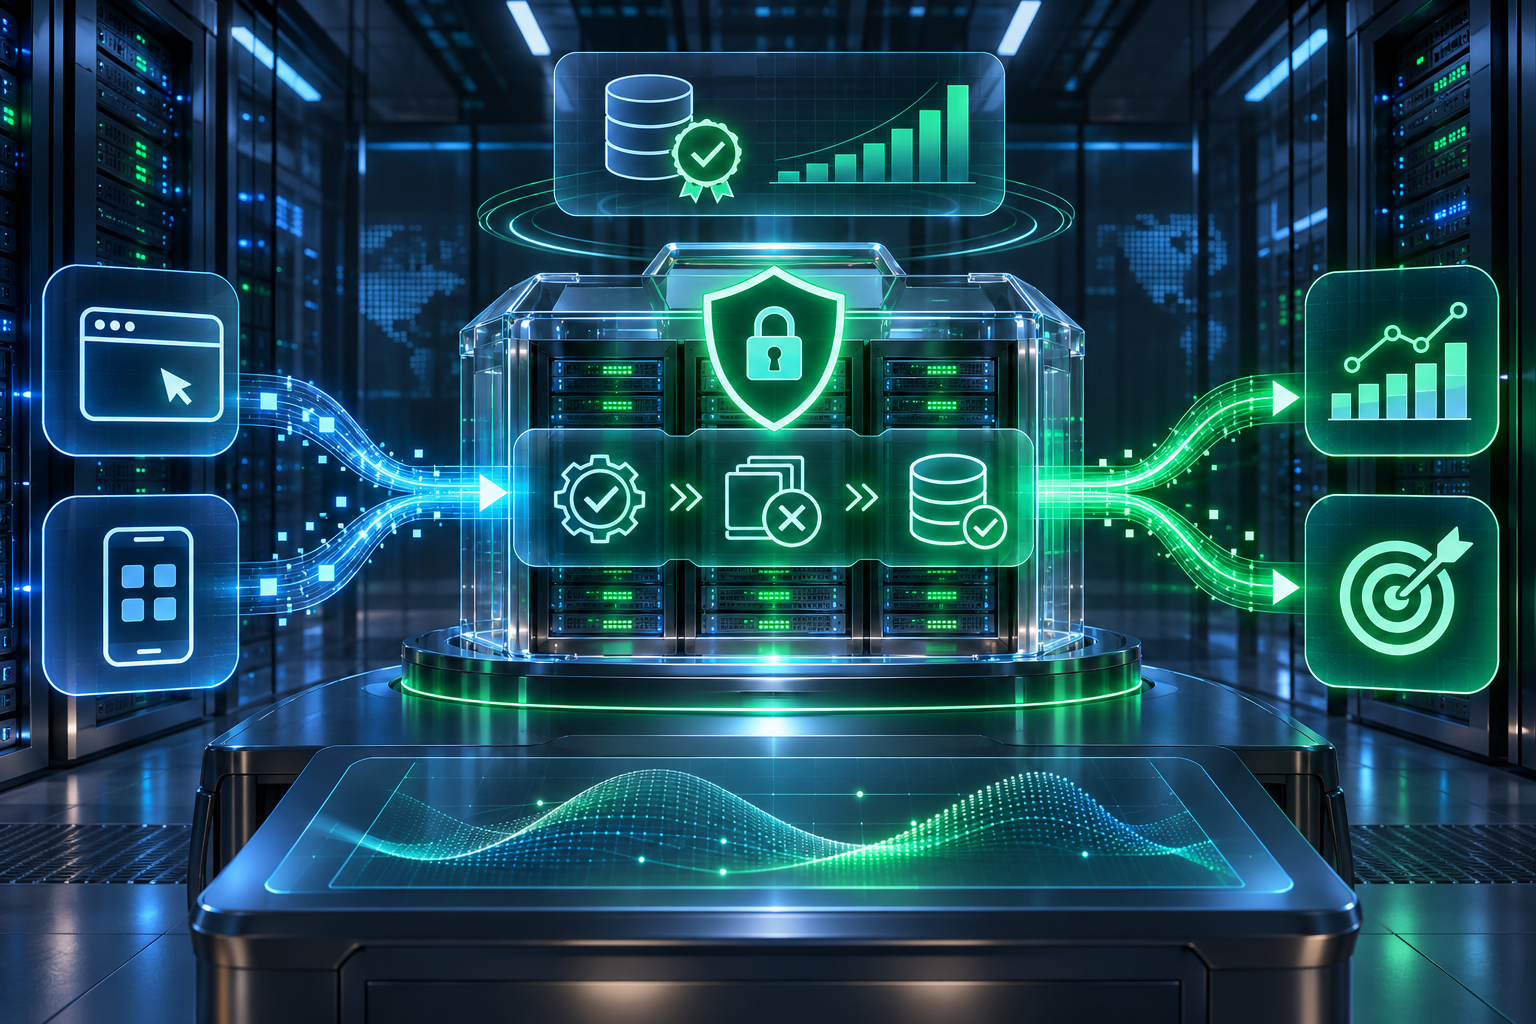
Server-side tracking przenosi część przetwarzania z przeglądarki do kontrolowanego środowiska serwerowego. Może poprawić walidację, odporność i zarządzanie danymi, lecz nie omija decyzji użytkownika ani nie tworzy brakujących faktów.
Projekt wymaga architektury, kosztów hostingu, zabezpieczeń, logów i odpowiedzialności. Bez utrzymania staje się kolejnym niewidocznym punktem awarii.
Najpierw uporządkuj konfigurację zdarzeń oraz mechanizm zgód.
Kiedy ma sens
Warstwa serwerowa pomaga przy wielu źródłach, potrzebie walidacji i kontroli endpointu.
Nie wdrażaj jej wyłącznie jako obietnicy odzyskania wszystkich danych.
Zdefiniuj problem i mierzalny wynik przed projektem.
Przykład praktyczny. W obszarze „Kiedy ma sens” rozpocznij od jednego scenariusza możliwego do powtórzenia przez inną osobę. Zapisz stronę wejścia, urządzenie, źródło ruchu, stan zgody i działanie użytkownika. Następnie określ, co powinno pojawić się w warstwie danych, żądaniu sieciowym oraz raporcie. Dla artykułu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” taki scenariusz stanowi punkt odniesienia: jeżeli wynik zmienia się po odświeżeniu, zmianie podstrony albo ponownym kliknięciu, konfiguracja wymaga dalszej diagnostyki przed publikacją.
Odpowiedzialność i kolejność. Dla artykułu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” i obszaru „Kiedy ma sens” na etapie inwentaryzacji główną odpowiedzialność przejmuje właściciel serwisu, ale wynik powinien zostać sprawdzony również przez osobę korzystającą z raportu. W zadaniu wdrożeniowym umieść warunek rozpoczęcia, oczekiwane parametry, przykładowy zrzut oraz definicję sukcesu. Nie łącz kilku niezależnych zmian w jednej publikacji. Oddziel modyfikację strony, kontenera, mechanizmu zgód i raportu, aby w razie rozbieżności można było wskazać konkretną przyczynę i bezpiecznie przywrócić poprzednią wersję.
Kontrola jakości: „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” — „Kiedy ma sens”. Dla zagadnienia „Kiedy ma sens” wykonaj test pozytywny, negatywny i brzegowy. Test pozytywny potwierdza prawidłową akcję, negatywny sprawdza brak zdarzenia po przerwaniu procesu, a brzegowy obejmuje nietypowe zachowanie: podwójne kliknięcie, powrót, utratę sieci, odmowę zgody albo przejście między domenami. Wyniki zapisz razem z datą i wersją konfiguracji. Dzięki temu kolejny audyt nie zaczyna się od zgadywania, lecz od porównania z udokumentowanym stanem.
Interpretacja po wdrożeniu: „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” — „Kiedy ma sens”. Pierwsze dane dla „Kiedy ma sens” oceniaj w kontekście wolumenu ruchu, sezonowości i zmian w ofercie. Nie zakładaj, że każda różnica jest skutkiem implementacji. Porównaj proporcje między etapami, udział urządzeń i jakość kontaktów, a następnie sprawdź surową próbę zdarzeń. Jeżeli raport jest poprawny technicznie, lecz nie odpowiada na pytanie biznesowe, wróć do planu pomiaru zamiast dodawać kolejne wykresy. Celem pozostaje decyzja oparta na wiarygodnych danych, nie sama obecność tagu.
W ramach tematu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” obszar „Kiedy ma sens” należy oceniać na danych z produkcji, a nie wyłącznie w konfiguracji testowej. Zapisz URL, urządzenie, stan zgody, czas wykonania i oczekiwany rezultat. Jeżeli wynik różni się między szablonami, szukaj przyczyny w warstwie danych, kolejności tagów lub warunkach uruchamiania. Po poprawce powtórz identyczny scenariusz i zachowaj dowód odbioru.
Architektura przepływu
Dane biegną z klienta do bramy, która je sprawdza i wysyła dalej.
Dokumentuj każdy etap, format, retencję i właściciela.
Narysuj przepływ dla zgody, odmowy, błędu i ponowienia.
Przykład praktyczny. W obszarze „Architektura przepływu” rozpocznij od jednego scenariusza możliwego do powtórzenia przez inną osobę. Zapisz stronę wejścia, urządzenie, źródło ruchu, stan zgody i działanie użytkownika. Następnie określ, co powinno pojawić się w warstwie danych, żądaniu sieciowym oraz raporcie. Dla artykułu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” taki scenariusz stanowi punkt odniesienia: jeżeli wynik zmienia się po odświeżeniu, zmianie podstrony albo ponownym kliknięciu, konfiguracja wymaga dalszej diagnostyki przed publikacją.
Odpowiedzialność i kolejność. Dla artykułu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” i obszaru „Architektura przepływu” na etapie projektowania główną odpowiedzialność przejmuje analityk, ale wynik powinien zostać sprawdzony również przez osobę korzystającą z raportu. W zadaniu wdrożeniowym umieść warunek rozpoczęcia, oczekiwane parametry, przykładowy zrzut oraz definicję sukcesu. Nie łącz kilku niezależnych zmian w jednej publikacji. Oddziel modyfikację strony, kontenera, mechanizmu zgód i raportu, aby w razie rozbieżności można było wskazać konkretną przyczynę i bezpiecznie przywrócić poprzednią wersję.
Kontrola jakości: „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” — „Architektura przepływu”. Dla zagadnienia „Architektura przepływu” wykonaj test pozytywny, negatywny i brzegowy. Test pozytywny potwierdza prawidłową akcję, negatywny sprawdza brak zdarzenia po przerwaniu procesu, a brzegowy obejmuje nietypowe zachowanie: podwójne kliknięcie, powrót, utratę sieci, odmowę zgody albo przejście między domenami. Wyniki zapisz razem z datą i wersją konfiguracji. Dzięki temu kolejny audyt nie zaczyna się od zgadywania, lecz od porównania z udokumentowanym stanem.
Interpretacja po wdrożeniu: „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” — „Architektura przepływu”. Pierwsze dane dla „Architektura przepływu” oceniaj w kontekście wolumenu ruchu, sezonowości i zmian w ofercie. Nie zakładaj, że każda różnica jest skutkiem implementacji. Porównaj proporcje między etapami, udział urządzeń i jakość kontaktów, a następnie sprawdź surową próbę zdarzeń. Jeżeli raport jest poprawny technicznie, lecz nie odpowiada na pytanie biznesowe, wróć do planu pomiaru zamiast dodawać kolejne wykresy. Celem pozostaje decyzja oparta na wiarygodnych danych, nie sama obecność tagu.
W ramach tematu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” obszar „Architektura przepływu” należy oceniać na danych z produkcji, a nie wyłącznie w konfiguracji testowej. Zapisz URL, urządzenie, stan zgody, czas wykonania i oczekiwany rezultat. Jeżeli wynik różni się między szablonami, szukaj przyczyny w warstwie danych, kolejności tagów lub warunkach uruchamiania. Po poprawce powtórz identyczny scenariusz i zachowaj dowód odbioru.
Endpoint first-party
Własna subdomena może uporządkować ruch, ale wymaga DNS, TLS i bezpieczeństwa.
Ogranicz metody, źródła i rozmiar żądania; stosuj kontrolę nadużyć.
Testuj certyfikat, odpowiedzi, cache i dostępność z różnych sieci.
Przykład praktyczny. W obszarze „Endpoint first-party” rozpocznij od jednego scenariusza możliwego do powtórzenia przez inną osobę. Zapisz stronę wejścia, urządzenie, źródło ruchu, stan zgody i działanie użytkownika. Następnie określ, co powinno pojawić się w warstwie danych, żądaniu sieciowym oraz raporcie. Dla artykułu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” taki scenariusz stanowi punkt odniesienia: jeżeli wynik zmienia się po odświeżeniu, zmianie podstrony albo ponownym kliknięciu, konfiguracja wymaga dalszej diagnostyki przed publikacją.
Odpowiedzialność i kolejność. Dla artykułu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” i obszaru „Endpoint first-party” na etapie konfiguracji główną odpowiedzialność przejmuje programista, ale wynik powinien zostać sprawdzony również przez osobę korzystającą z raportu. W zadaniu wdrożeniowym umieść warunek rozpoczęcia, oczekiwane parametry, przykładowy zrzut oraz definicję sukcesu. Nie łącz kilku niezależnych zmian w jednej publikacji. Oddziel modyfikację strony, kontenera, mechanizmu zgód i raportu, aby w razie rozbieżności można było wskazać konkretną przyczynę i bezpiecznie przywrócić poprzednią wersję.
Kontrola jakości: „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” — „Endpoint first-party”. Dla zagadnienia „Endpoint first-party” wykonaj test pozytywny, negatywny i brzegowy. Test pozytywny potwierdza prawidłową akcję, negatywny sprawdza brak zdarzenia po przerwaniu procesu, a brzegowy obejmuje nietypowe zachowanie: podwójne kliknięcie, powrót, utratę sieci, odmowę zgody albo przejście między domenami. Wyniki zapisz razem z datą i wersją konfiguracji. Dzięki temu kolejny audyt nie zaczyna się od zgadywania, lecz od porównania z udokumentowanym stanem.
Interpretacja po wdrożeniu: „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” — „Endpoint first-party”. Pierwsze dane dla „Endpoint first-party” oceniaj w kontekście wolumenu ruchu, sezonowości i zmian w ofercie. Nie zakładaj, że każda różnica jest skutkiem implementacji. Porównaj proporcje między etapami, udział urządzeń i jakość kontaktów, a następnie sprawdź surową próbę zdarzeń. Jeżeli raport jest poprawny technicznie, lecz nie odpowiada na pytanie biznesowe, wróć do planu pomiaru zamiast dodawać kolejne wykresy. Celem pozostaje decyzja oparta na wiarygodnych danych, nie sama obecność tagu.
W ramach tematu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” obszar „Endpoint first-party” należy oceniać na danych z produkcji, a nie wyłącznie w konfiguracji testowej. Zapisz URL, urządzenie, stan zgody, czas wykonania i oczekiwany rezultat. Jeżeli wynik różni się między szablonami, szukaj przyczyny w warstwie danych, kolejności tagów lub warunkach uruchamiania. Po poprawce powtórz identyczny scenariusz i zachowaj dowód odbioru.
Walidacja danych
Serwer może odrzucać niepełne, błędne i niedozwolone pola.
Ustal schemat, typy, listy wartości oraz anonimizację przed wysyłką.
Raportuj odsetek odrzuceń z powodem, bez zapisywania danych wrażliwych.
Przykład praktyczny. W obszarze „Walidacja danych” rozpocznij od jednego scenariusza możliwego do powtórzenia przez inną osobę. Zapisz stronę wejścia, urządzenie, źródło ruchu, stan zgody i działanie użytkownika. Następnie określ, co powinno pojawić się w warstwie danych, żądaniu sieciowym oraz raporcie. Dla artykułu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” taki scenariusz stanowi punkt odniesienia: jeżeli wynik zmienia się po odświeżeniu, zmianie podstrony albo ponownym kliknięciu, konfiguracja wymaga dalszej diagnostyki przed publikacją.
Odpowiedzialność i kolejność. Dla artykułu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” i obszaru „Walidacja danych” na etapie testów funkcjonalnych główną odpowiedzialność przejmuje specjalista marketingu, ale wynik powinien zostać sprawdzony również przez osobę korzystającą z raportu. W zadaniu wdrożeniowym umieść warunek rozpoczęcia, oczekiwane parametry, przykładowy zrzut oraz definicję sukcesu. Nie łącz kilku niezależnych zmian w jednej publikacji. Oddziel modyfikację strony, kontenera, mechanizmu zgód i raportu, aby w razie rozbieżności można było wskazać konkretną przyczynę i bezpiecznie przywrócić poprzednią wersję.
Kontrola jakości: „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” — „Walidacja danych”. Dla zagadnienia „Walidacja danych” wykonaj test pozytywny, negatywny i brzegowy. Test pozytywny potwierdza prawidłową akcję, negatywny sprawdza brak zdarzenia po przerwaniu procesu, a brzegowy obejmuje nietypowe zachowanie: podwójne kliknięcie, powrót, utratę sieci, odmowę zgody albo przejście między domenami. Wyniki zapisz razem z datą i wersją konfiguracji. Dzięki temu kolejny audyt nie zaczyna się od zgadywania, lecz od porównania z udokumentowanym stanem.
Interpretacja po wdrożeniu: „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” — „Walidacja danych”. Pierwsze dane dla „Walidacja danych” oceniaj w kontekście wolumenu ruchu, sezonowości i zmian w ofercie. Nie zakładaj, że każda różnica jest skutkiem implementacji. Porównaj proporcje między etapami, udział urządzeń i jakość kontaktów, a następnie sprawdź surową próbę zdarzeń. Jeżeli raport jest poprawny technicznie, lecz nie odpowiada na pytanie biznesowe, wróć do planu pomiaru zamiast dodawać kolejne wykresy. Celem pozostaje decyzja oparta na wiarygodnych danych, nie sama obecność tagu.
W ramach tematu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” obszar „Walidacja danych” należy oceniać na danych z produkcji, a nie wyłącznie w konfiguracji testowej. Zapisz URL, urządzenie, stan zgody, czas wykonania i oczekiwany rezultat. Jeżeli wynik różni się między szablonami, szukaj przyczyny w warstwie danych, kolejności tagów lub warunkach uruchamiania. Po poprawce powtórz identyczny scenariusz i zachowaj dowód odbioru.
Deduplikacja
Równoległy sygnał przeglądarkowy i serwerowy może podwoić konwersję.
Użyj wspólnego identyfikatora zdarzenia i kontrolowanego okna.
Porównaj liczbę wejść, wyjść i deduplikowanych rekordów.
Przykład praktyczny. W obszarze „Deduplikacja” rozpocznij od jednego scenariusza możliwego do powtórzenia przez inną osobę. Zapisz stronę wejścia, urządzenie, źródło ruchu, stan zgody i działanie użytkownika. Następnie określ, co powinno pojawić się w warstwie danych, żądaniu sieciowym oraz raporcie. Dla artykułu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” taki scenariusz stanowi punkt odniesienia: jeżeli wynik zmienia się po odświeżeniu, zmianie podstrony albo ponownym kliknięciu, konfiguracja wymaga dalszej diagnostyki przed publikacją.
Odpowiedzialność i kolejność. Dla artykułu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” i obszaru „Deduplikacja” na etapie kontroli prywatności główną odpowiedzialność przejmuje osoba odpowiedzialna za prywatność, ale wynik powinien zostać sprawdzony również przez osobę korzystającą z raportu. W zadaniu wdrożeniowym umieść warunek rozpoczęcia, oczekiwane parametry, przykładowy zrzut oraz definicję sukcesu. Nie łącz kilku niezależnych zmian w jednej publikacji. Oddziel modyfikację strony, kontenera, mechanizmu zgód i raportu, aby w razie rozbieżności można było wskazać konkretną przyczynę i bezpiecznie przywrócić poprzednią wersję.
Kontrola jakości: „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” — „Deduplikacja”. Dla zagadnienia „Deduplikacja” wykonaj test pozytywny, negatywny i brzegowy. Test pozytywny potwierdza prawidłową akcję, negatywny sprawdza brak zdarzenia po przerwaniu procesu, a brzegowy obejmuje nietypowe zachowanie: podwójne kliknięcie, powrót, utratę sieci, odmowę zgody albo przejście między domenami. Wyniki zapisz razem z datą i wersją konfiguracji. Dzięki temu kolejny audyt nie zaczyna się od zgadywania, lecz od porównania z udokumentowanym stanem.
Interpretacja po wdrożeniu: „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” — „Deduplikacja”. Pierwsze dane dla „Deduplikacja” oceniaj w kontekście wolumenu ruchu, sezonowości i zmian w ofercie. Nie zakładaj, że każda różnica jest skutkiem implementacji. Porównaj proporcje między etapami, udział urządzeń i jakość kontaktów, a następnie sprawdź surową próbę zdarzeń. Jeżeli raport jest poprawny technicznie, lecz nie odpowiada na pytanie biznesowe, wróć do planu pomiaru zamiast dodawać kolejne wykresy. Celem pozostaje decyzja oparta na wiarygodnych danych, nie sama obecność tagu.
W ramach tematu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” obszar „Deduplikacja” należy oceniać na danych z produkcji, a nie wyłącznie w konfiguracji testowej. Zapisz URL, urządzenie, stan zgody, czas wykonania i oczekiwany rezultat. Jeżeli wynik różni się między szablonami, szukaj przyczyny w warstwie danych, kolejności tagów lub warunkach uruchamiania. Po poprawce powtórz identyczny scenariusz i zachowaj dowód odbioru.
Zgody i prywatność
Serwer nie zwalnia z respektowania wyboru i minimalizacji.
Przekazuj stan zgody, filtruj pola i ustal retencję logów.
Testuj brak zgody tak samo dokładnie jak pełną zgodę.
Przykład praktyczny. W obszarze „Zgody i prywatność” rozpocznij od jednego scenariusza możliwego do powtórzenia przez inną osobę. Zapisz stronę wejścia, urządzenie, źródło ruchu, stan zgody i działanie użytkownika. Następnie określ, co powinno pojawić się w warstwie danych, żądaniu sieciowym oraz raporcie. Dla artykułu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” taki scenariusz stanowi punkt odniesienia: jeżeli wynik zmienia się po odświeżeniu, zmianie podstrony albo ponownym kliknięciu, konfiguracja wymaga dalszej diagnostyki przed publikacją.
Odpowiedzialność i kolejność. Dla artykułu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” i obszaru „Zgody i prywatność” na etapie odbioru danych główną odpowiedzialność przejmuje zespół sprzedaży, ale wynik powinien zostać sprawdzony również przez osobę korzystającą z raportu. W zadaniu wdrożeniowym umieść warunek rozpoczęcia, oczekiwane parametry, przykładowy zrzut oraz definicję sukcesu. Nie łącz kilku niezależnych zmian w jednej publikacji. Oddziel modyfikację strony, kontenera, mechanizmu zgód i raportu, aby w razie rozbieżności można było wskazać konkretną przyczynę i bezpiecznie przywrócić poprzednią wersję.
Kontrola jakości: „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” — „Zgody i prywatność”. Dla zagadnienia „Zgody i prywatność” wykonaj test pozytywny, negatywny i brzegowy. Test pozytywny potwierdza prawidłową akcję, negatywny sprawdza brak zdarzenia po przerwaniu procesu, a brzegowy obejmuje nietypowe zachowanie: podwójne kliknięcie, powrót, utratę sieci, odmowę zgody albo przejście między domenami. Wyniki zapisz razem z datą i wersją konfiguracji. Dzięki temu kolejny audyt nie zaczyna się od zgadywania, lecz od porównania z udokumentowanym stanem.
Interpretacja po wdrożeniu: „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” — „Zgody i prywatność”. Pierwsze dane dla „Zgody i prywatność” oceniaj w kontekście wolumenu ruchu, sezonowości i zmian w ofercie. Nie zakładaj, że każda różnica jest skutkiem implementacji. Porównaj proporcje między etapami, udział urządzeń i jakość kontaktów, a następnie sprawdź surową próbę zdarzeń. Jeżeli raport jest poprawny technicznie, lecz nie odpowiada na pytanie biznesowe, wróć do planu pomiaru zamiast dodawać kolejne wykresy. Celem pozostaje decyzja oparta na wiarygodnych danych, nie sama obecność tagu.
W ramach tematu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” obszar „Zgody i prywatność” należy oceniać na danych z produkcji, a nie wyłącznie w konfiguracji testowej. Zapisz URL, urządzenie, stan zgody, czas wykonania i oczekiwany rezultat. Jeżeli wynik różni się między szablonami, szukaj przyczyny w warstwie danych, kolejności tagów lub warunkach uruchamiania. Po poprawce powtórz identyczny scenariusz i zachowaj dowód odbioru.
Monitoring i koszty
Awaria może nie być widoczna na stronie, a zatrzymać wszystkie dane.
Monitoruj opóźnienie, błędy, wolumen, koszt i dostępność endpointu.
Ustaw alerty oraz procedurę przywrócenia prostszego przepływu.
Przykład praktyczny. W obszarze „Monitoring i koszty” rozpocznij od jednego scenariusza możliwego do powtórzenia przez inną osobę. Zapisz stronę wejścia, urządzenie, źródło ruchu, stan zgody i działanie użytkownika. Następnie określ, co powinno pojawić się w warstwie danych, żądaniu sieciowym oraz raporcie. Dla artykułu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” taki scenariusz stanowi punkt odniesienia: jeżeli wynik zmienia się po odświeżeniu, zmianie podstrony albo ponownym kliknięciu, konfiguracja wymaga dalszej diagnostyki przed publikacją.
Odpowiedzialność i kolejność. Dla artykułu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” i obszaru „Monitoring i koszty” na etapie monitoringu główną odpowiedzialność przejmuje administrator, ale wynik powinien zostać sprawdzony również przez osobę korzystającą z raportu. W zadaniu wdrożeniowym umieść warunek rozpoczęcia, oczekiwane parametry, przykładowy zrzut oraz definicję sukcesu. Nie łącz kilku niezależnych zmian w jednej publikacji. Oddziel modyfikację strony, kontenera, mechanizmu zgód i raportu, aby w razie rozbieżności można było wskazać konkretną przyczynę i bezpiecznie przywrócić poprzednią wersję.
Kontrola jakości: „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” — „Monitoring i koszty”. Dla zagadnienia „Monitoring i koszty” wykonaj test pozytywny, negatywny i brzegowy. Test pozytywny potwierdza prawidłową akcję, negatywny sprawdza brak zdarzenia po przerwaniu procesu, a brzegowy obejmuje nietypowe zachowanie: podwójne kliknięcie, powrót, utratę sieci, odmowę zgody albo przejście między domenami. Wyniki zapisz razem z datą i wersją konfiguracji. Dzięki temu kolejny audyt nie zaczyna się od zgadywania, lecz od porównania z udokumentowanym stanem.
Interpretacja po wdrożeniu: „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” — „Monitoring i koszty”. Pierwsze dane dla „Monitoring i koszty” oceniaj w kontekście wolumenu ruchu, sezonowości i zmian w ofercie. Nie zakładaj, że każda różnica jest skutkiem implementacji. Porównaj proporcje między etapami, udział urządzeń i jakość kontaktów, a następnie sprawdź surową próbę zdarzeń. Jeżeli raport jest poprawny technicznie, lecz nie odpowiada na pytanie biznesowe, wróć do planu pomiaru zamiast dodawać kolejne wykresy. Celem pozostaje decyzja oparta na wiarygodnych danych, nie sama obecność tagu.
W ramach tematu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” obszar „Monitoring i koszty” należy oceniać na danych z produkcji, a nie wyłącznie w konfiguracji testowej. Zapisz URL, urządzenie, stan zgody, czas wykonania i oczekiwany rezultat. Jeżeli wynik różni się między szablonami, szukaj przyczyny w warstwie danych, kolejności tagów lub warunkach uruchamiania. Po poprawce powtórz identyczny scenariusz i zachowaj dowód odbioru.
Migracja etapami
Jednoczesne przeniesienie wszystkich tagów utrudnia diagnozę.
Zacznij od jednego zdarzenia, porównaj strumienie i rozszerzaj po odbiorze.
Zachowaj próbę kontrolną oraz raport różnic przed wyłączeniem starej ścieżki.
Przykład praktyczny. W obszarze „Migracja etapami” rozpocznij od jednego scenariusza możliwego do powtórzenia przez inną osobę. Zapisz stronę wejścia, urządzenie, źródło ruchu, stan zgody i działanie użytkownika. Następnie określ, co powinno pojawić się w warstwie danych, żądaniu sieciowym oraz raporcie. Dla artykułu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” taki scenariusz stanowi punkt odniesienia: jeżeli wynik zmienia się po odświeżeniu, zmianie podstrony albo ponownym kliknięciu, konfiguracja wymaga dalszej diagnostyki przed publikacją.
Odpowiedzialność i kolejność. Dla artykułu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” i obszaru „Migracja etapami” na etapie cyklicznego przeglądu główną odpowiedzialność przejmuje osoba zatwierdzająca publikację, ale wynik powinien zostać sprawdzony również przez osobę korzystającą z raportu. W zadaniu wdrożeniowym umieść warunek rozpoczęcia, oczekiwane parametry, przykładowy zrzut oraz definicję sukcesu. Nie łącz kilku niezależnych zmian w jednej publikacji. Oddziel modyfikację strony, kontenera, mechanizmu zgód i raportu, aby w razie rozbieżności można było wskazać konkretną przyczynę i bezpiecznie przywrócić poprzednią wersję.
Kontrola jakości: „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” — „Migracja etapami”. Dla zagadnienia „Migracja etapami” wykonaj test pozytywny, negatywny i brzegowy. Test pozytywny potwierdza prawidłową akcję, negatywny sprawdza brak zdarzenia po przerwaniu procesu, a brzegowy obejmuje nietypowe zachowanie: podwójne kliknięcie, powrót, utratę sieci, odmowę zgody albo przejście między domenami. Wyniki zapisz razem z datą i wersją konfiguracji. Dzięki temu kolejny audyt nie zaczyna się od zgadywania, lecz od porównania z udokumentowanym stanem.
Interpretacja po wdrożeniu: „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” — „Migracja etapami”. Pierwsze dane dla „Migracja etapami” oceniaj w kontekście wolumenu ruchu, sezonowości i zmian w ofercie. Nie zakładaj, że każda różnica jest skutkiem implementacji. Porównaj proporcje między etapami, udział urządzeń i jakość kontaktów, a następnie sprawdź surową próbę zdarzeń. Jeżeli raport jest poprawny technicznie, lecz nie odpowiada na pytanie biznesowe, wróć do planu pomiaru zamiast dodawać kolejne wykresy. Celem pozostaje decyzja oparta na wiarygodnych danych, nie sama obecność tagu.
W ramach tematu „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” obszar „Migracja etapami” należy oceniać na danych z produkcji, a nie wyłącznie w konfiguracji testowej. Zapisz URL, urządzenie, stan zgody, czas wykonania i oczekiwany rezultat. Jeżeli wynik różni się między szablonami, szukaj przyczyny w warstwie danych, kolejności tagów lub warunkach uruchamiania. Po poprawce powtórz identyczny scenariusz i zachowaj dowód odbioru.
Plan wdrożenia i odbioru
Pracę nad tematem „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” rozpocznij od zapisania stanu obecnego, celu biznesowego i właściciela danych. Zmiana analityczna jest gotowa dopiero wtedy, gdy zespół potrafi powtórzyć test i wyjaśnić znaczenie każdego kluczowego zdarzenia.
Przetestuj obszary: Kiedy ma sens, Architektura przepływu, Endpoint first-party, Walidacja danych. Użyj nowej sesji, zgody i odmowy, urządzenia mobilnego oraz scenariusza błędu. Następnie sprawdź: Deduplikacja, Zgody i prywatność, Monitoring i koszty, Migracja etapami. Zachowaj dowody z podglądu, sieci i raportu.
Po publikacji rozwiązania „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” porównaj wolumen, jakość i proporcje zdarzeń z okresem referencyjnym. Nagły wzrost nie zawsze oznacza sukces, a spadek nie zawsze błąd — wynik trzeba zestawić ze zmianami ruchu i procesu sprzedaży.
Lista kontrolna
- udokumentuj i sprawdź: kiedy ma sens,
- udokumentuj i sprawdź: architektura przepływu,
- udokumentuj i sprawdź: endpoint first-party,
- udokumentuj i sprawdź: walidacja danych,
- udokumentuj i sprawdź: deduplikacja,
- udokumentuj i sprawdź: zgody i prywatność,
- udokumentuj i sprawdź: monitoring i koszty,
- udokumentuj i sprawdź: migracja etapami,
Lista dla „Server-side tracking: kiedy poprawia jakość danych i jak go wdrożyć” ułatwia utrzymanie konfiguracji po zmianach strony. Najważniejsze scenariusze warto automatyzować, a pozostałe powtarzać przy każdym wdrożeniu wpływającym na formularz, zgody lub warstwę danych.
Najczęściej zadawane pytania
Czy server-side tracking omija zgody?
Nie. Musi respektować wybór użytkownika i zasady przetwarzania.
Czy odzyska wszystkie konwersje?
Nie. Może poprawić odporność i kontrolę, ale nie odtworzy nieistniejących danych.
Czy jest potrzebny małej stronie?
Nie zawsze; korzyść musi uzasadniać koszt oraz utrzymanie.
Jak uniknąć duplikatów?
Stosuj wspólny identyfikator zdarzenia i deduplikację.
Co monitorować?
Dostępność, błędy, opóźnienie, odrzucenia, wolumen i koszt.
